LR Parsing Techniques#
LR Parsing#
我們需要 identify 所有 handle,在 stack 裡面如果有看到某個 handle 出現了,要把箭頭右邊轉換成箭頭左邊
LR(k) 的意思
- L: left-to-right
- R: Rightmost derivation
- k: 還是需要 look-ahead 來獲取更多資訊
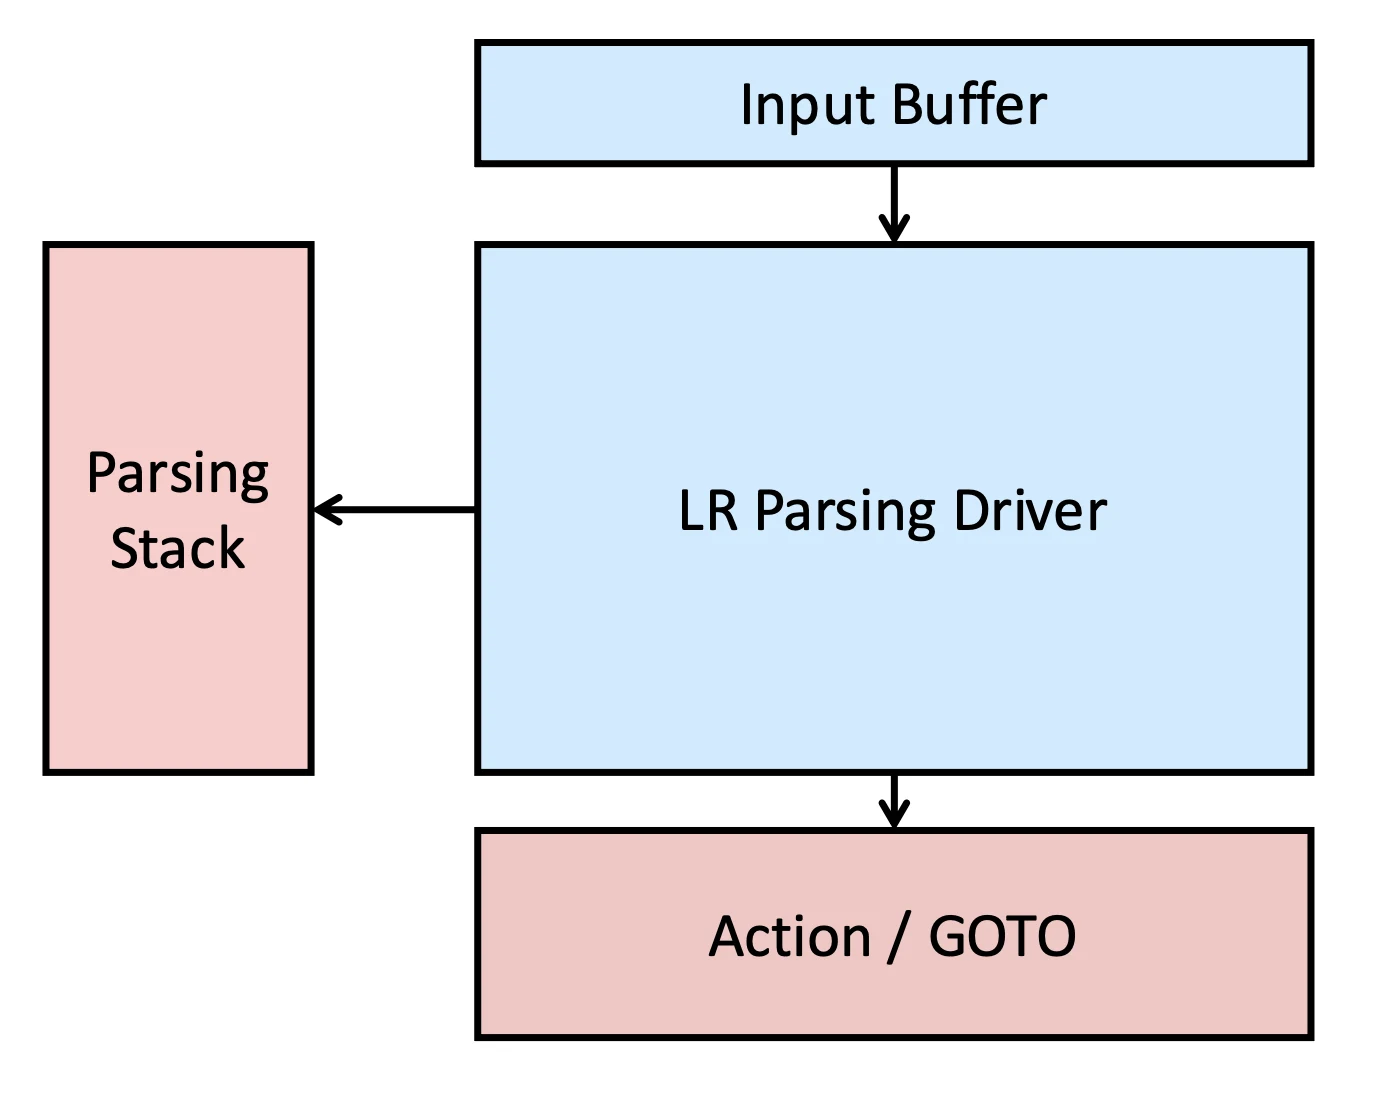 LR parser structure
一樣有 state machine,所以表裡面一樣有 state,根據 action,決定最後的 goto 要走到哪
- States
- GoTo Table
- Action Table:
Shift, Reduce, Error, Accept
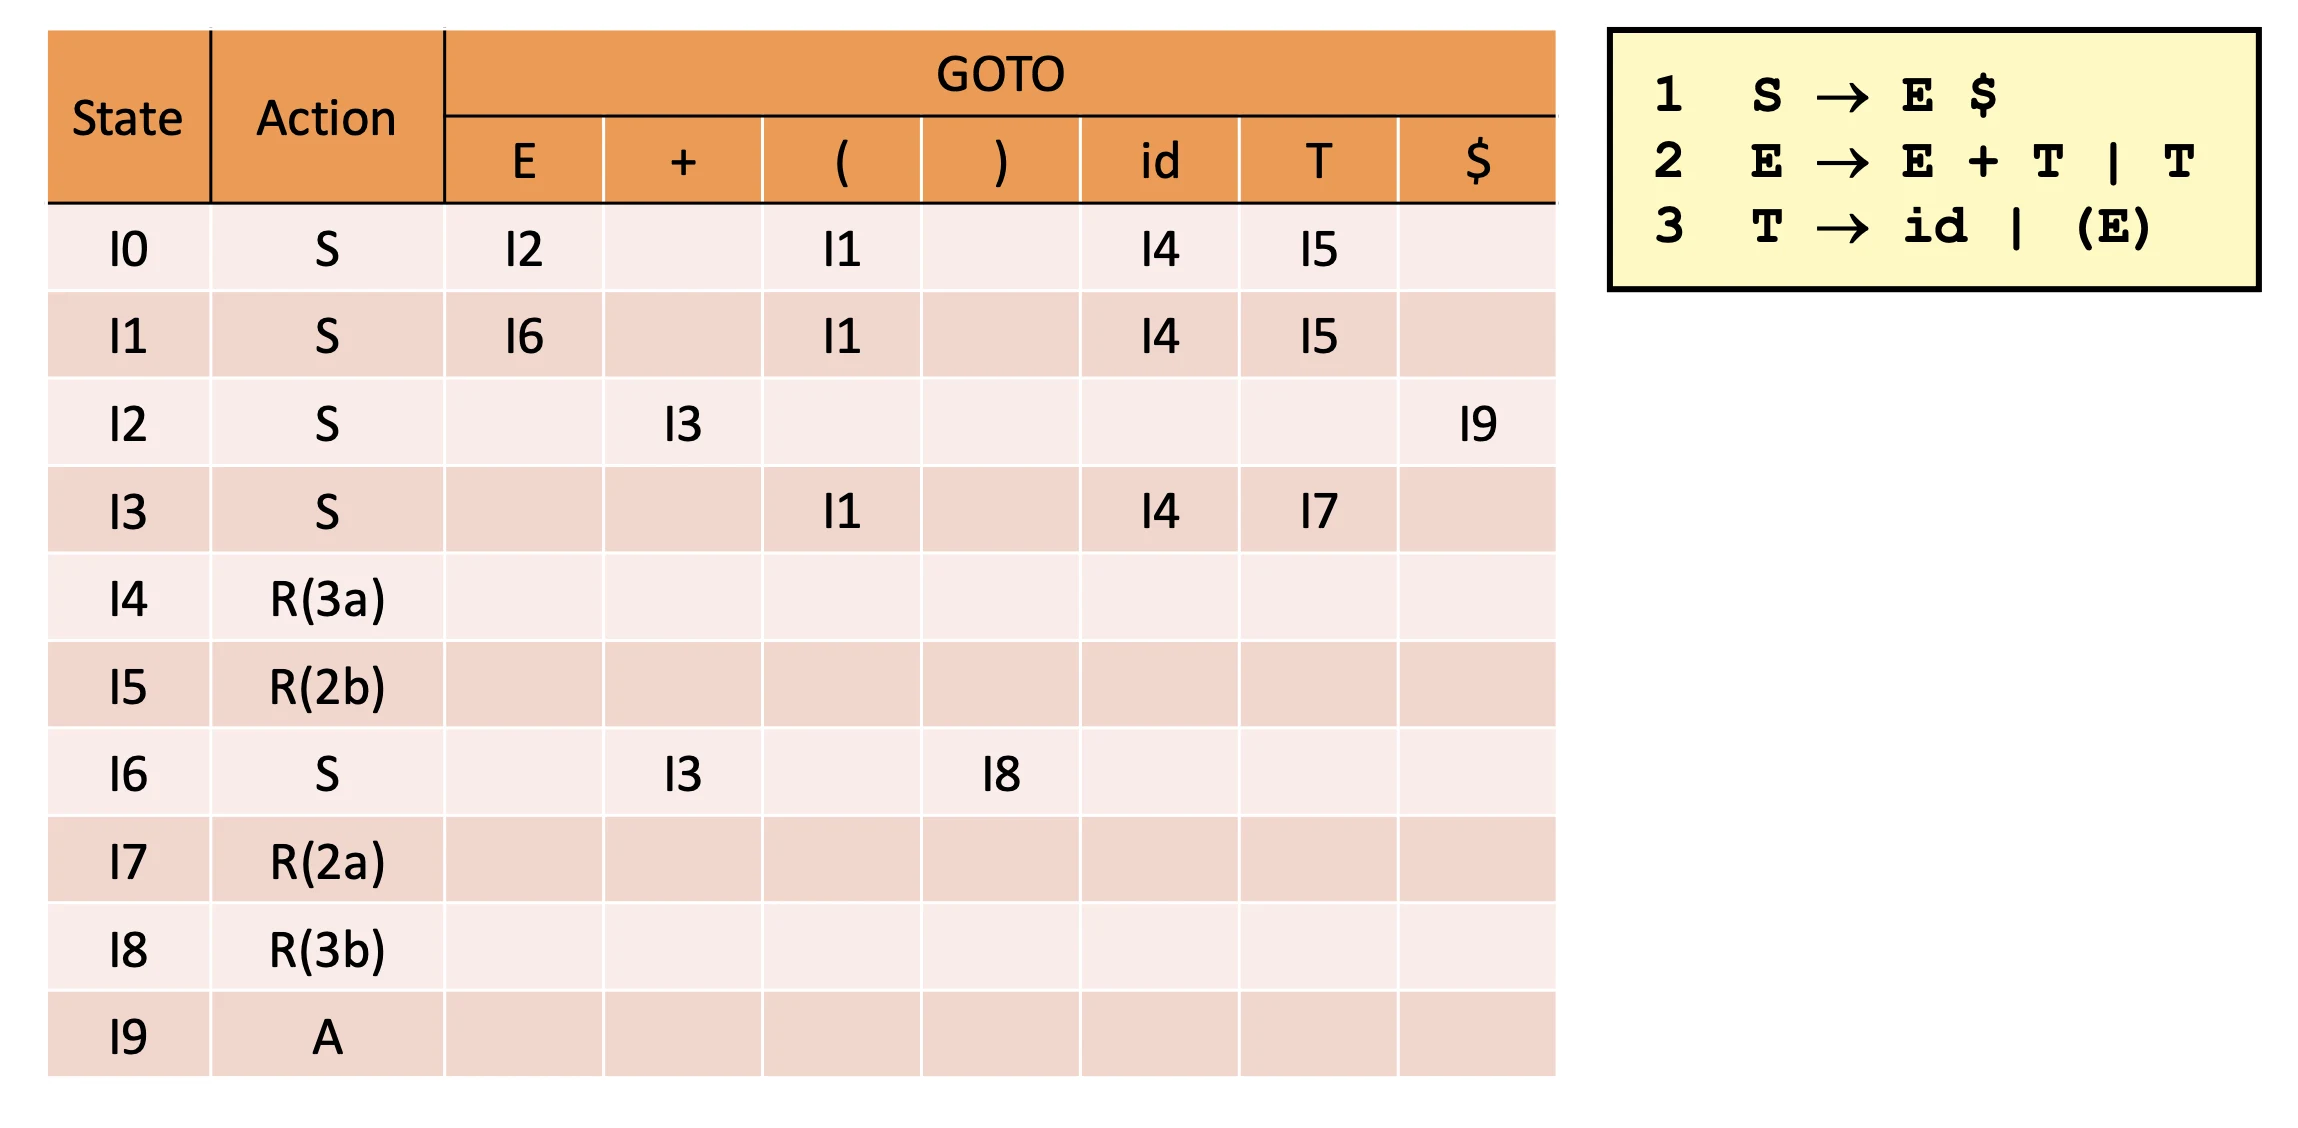 LR(0) parsing table
LR(0) parsing#
LR(0) item#
對於一個 Production A→X1X2⋯Xn,在右側任意位置插入一個 Dot (∙),即可形成一個 Item:
A→X1⋯Xi∙Xi+1⋯Xn,0≤i≤n
其中 Dot 表示目前 Parser 已經辨識到的位置。
LR(0) 還是需要 look-ahead 一個 token,0 的意思是版本,這裡引入一個 LR(0) item 的概念,我們會放一個 dot 在一串 production 裡面,意思是我們需要多少個 char 已經 match 了,假設我們有一個 rule A→XYZ 的話,那我們會有四種 items
- A→⋅ XYZ 這種情況稱為 fresh,因為啥都還沒 match
- A→X⋅YZ
- A→XY⋅Z
- A→XYZ ⋅ 這種情況稱為 reducible
這種 item 可以用一個 NFA 表示
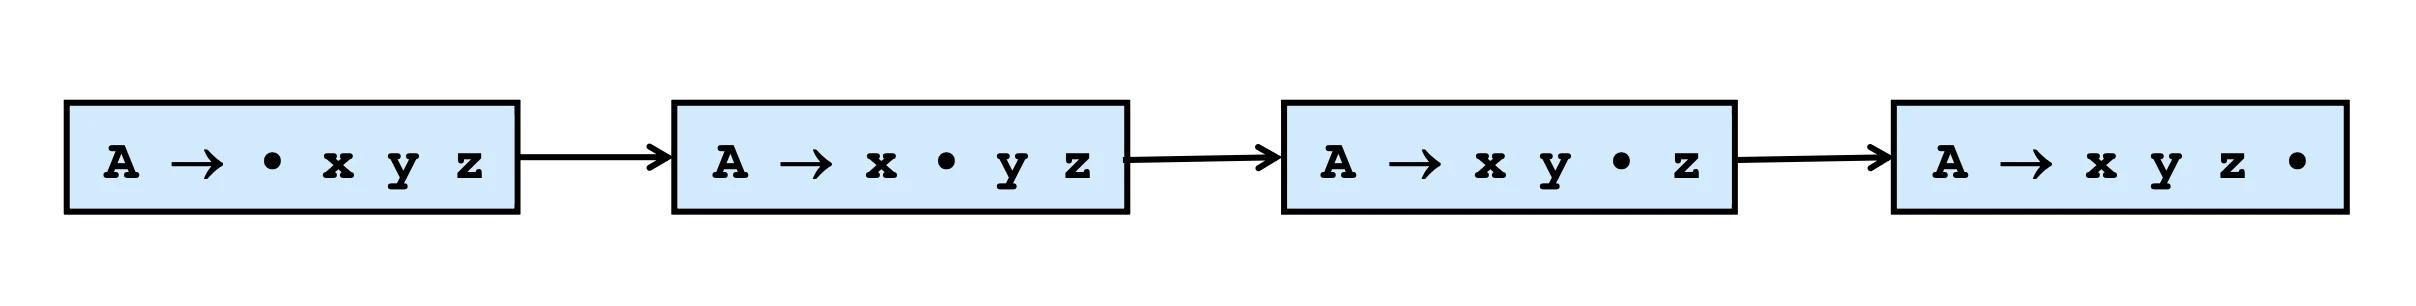 NFA of LR(0) item
Configuration Set#
假設我們讀到這三個 rule
stmt → • id := expr;
stmt → • id : stmt;
stmt → • id;
plaintext我們現在啥都沒讀到,那這三條 rule 都在我們的 Configuration Set 裡面,Configuration Set 描述的是目前 Parser 可能處於哪些解析狀態,所以如果我們讀到 id
stmt → id • := expr;
stmt → id • : stmt;
stmt → id • ;
plaintext我們可以知道 Configuration Set 裡面
- 第一條:如果接下來是
:=,可能是 Assignment
- 第二條:如果接下來是
:,可能是 Labeled Statement
- 第三條:還需要讀取
;,所以也還沒完成
接下來有兩個名詞 Predict 與 Recognize
- Predict: Dot 在最左邊,表示還沒有辨識這條 Production 的任何 Symbol
- Recognize: Dot 在最右邊,表示整條 Production 都已經辨識完成。
Closure#
Closure of I,I 是 a set of items
- I 裡面的所有 item 都在 Closure(I) 裡面
- 若 A→α∙Bβ 在 Closure(I) 中,則對每個 Production B→γ,加入 B→∙ γ。重複此過程,直到沒有新的 Item 可以加入為止(替換到 Dot 後面的那個 token 不是 non terminal 為止)
假設有以下 Grammar:
SAB→AB→aA∣b→c
一開始只有一個 Item:
I={S→∙AB}
Step 1: 因為 Dot 後面是 Nonterminal A,所以將所有 A 的 Productions 加入,並把 Dot 放在最左邊。
SAA→∙AB→∙aA→∙b
Step 2: 檢查新加入的 Items,因為 Dot 後面都是 Terminal(a、b),不需要再展開。
因此:
Closure(I)=⎩⎨⎧S→∙AB,A→∙aA,A→∙b⎭⎬⎫
Goto function#
也就是我們的 state machine 的 transition function,我們定義
給定 Item Set I 與 Grammar Symbol X:
GoTo(I,X)=Closure({A→αX∙β∣A→α∙Xβ∈I})
將 I 中所有 Dot 後面是 X 的 Items,將 Dot 向右移過 X,再對結果取 Closure,得到下一個 State
Sets-of-Item Construction#
透過 Closure 與 Goto 建立 LR Parser 的所有 States(Item Sets),每個 Item Set 對應 DFA 的一個 State,假設我們有
- I:一個 item Set,代表一個 state
- C:所有已找到的 item sets
- X:任意 symbol
Step 1:建立 Initial State
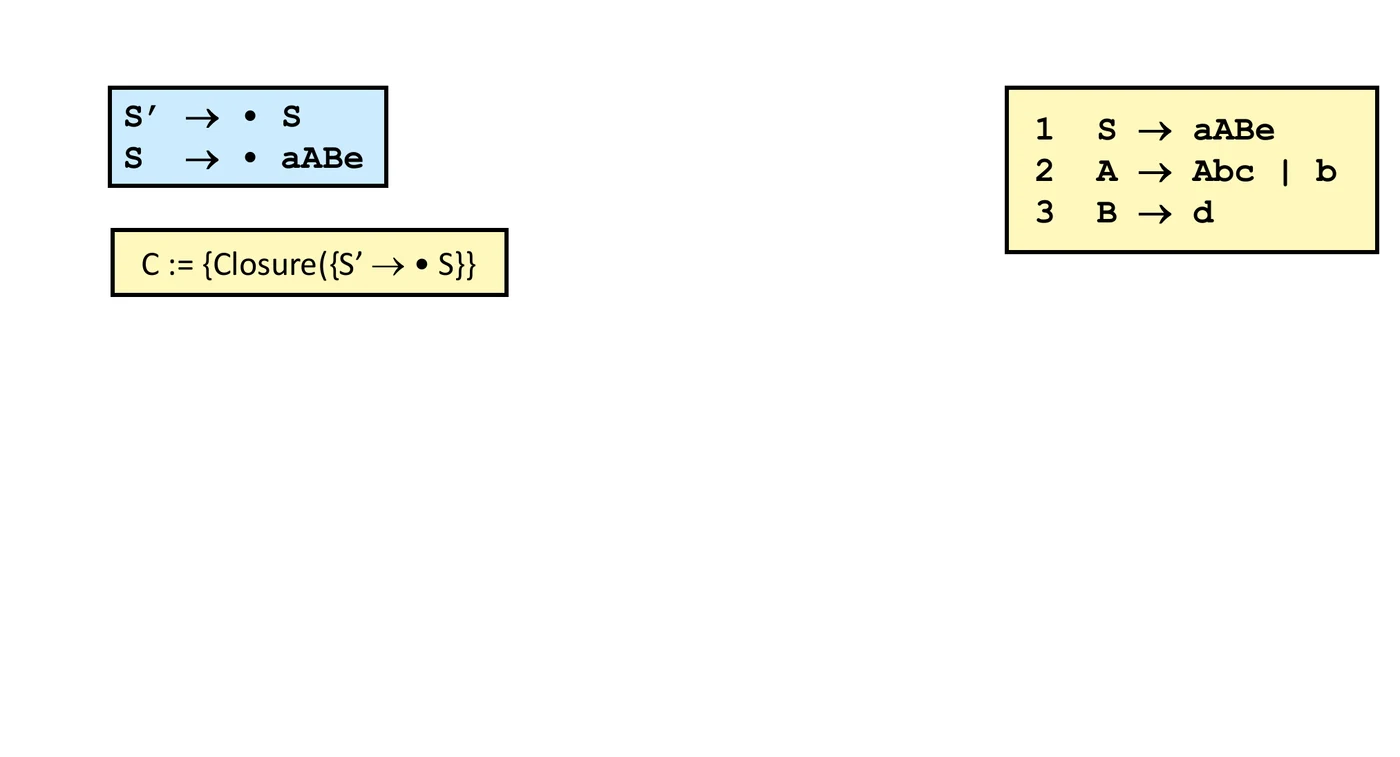
C={Closure({S′→∙S})}
其中 S′→S 是 Augmented Grammar 額外加入的 Production,用來判斷 Parsing 是否完成。
Step 2:尋找新的 States
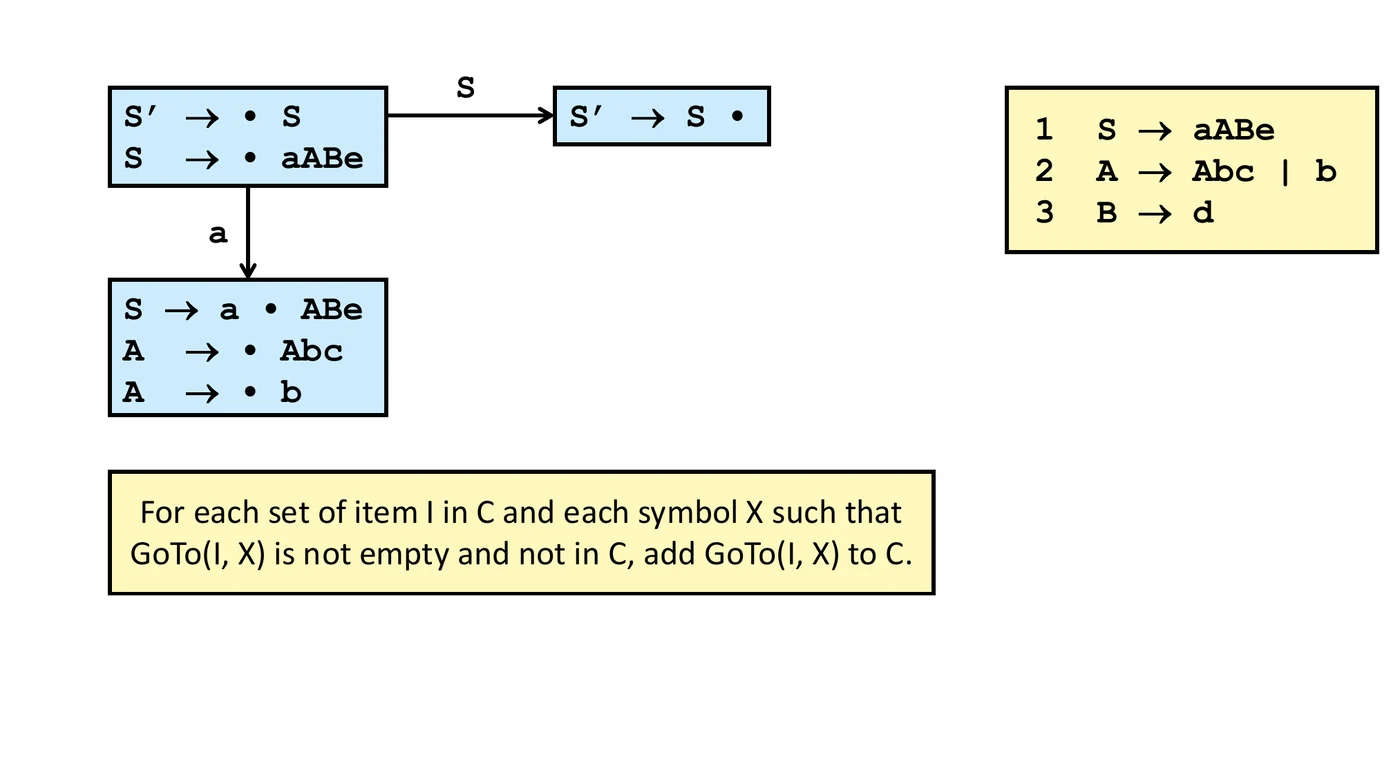
對每個 I∈C 與 Grammar Symbol X,計算:
Inew=GoTo(I,X)
若 Inew=∅,且 Inew∈/C,則將其加入 C。
Step 3:重複直到沒有新 State
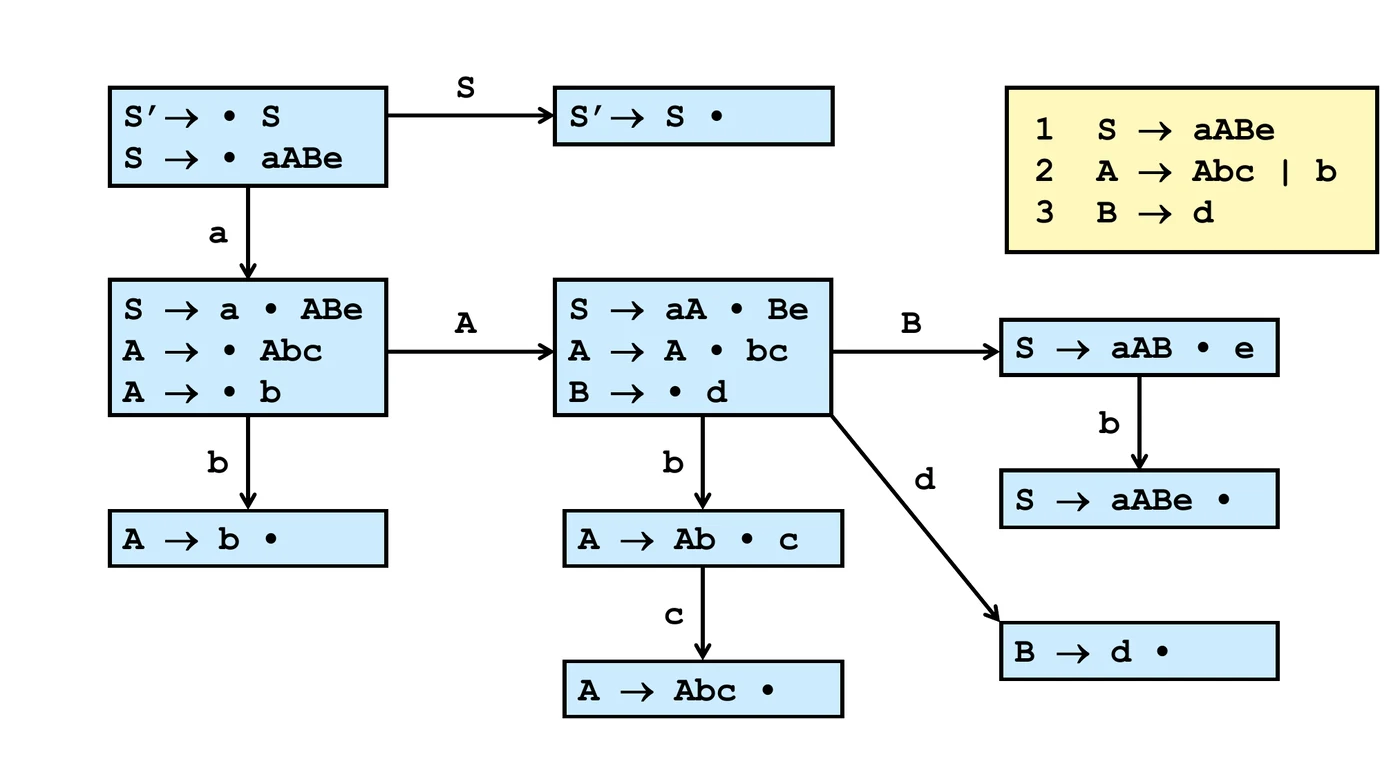
持續對所有 Item Sets 執行 Step 2,直到沒有新的 Item Set 可以加入 C。
透過這個流程就可以找出所有 DFA 裡面的 State,很像 subset construction,建立出的 DFA 將用於後續的 LR Parsing Table Construction
Action Table#
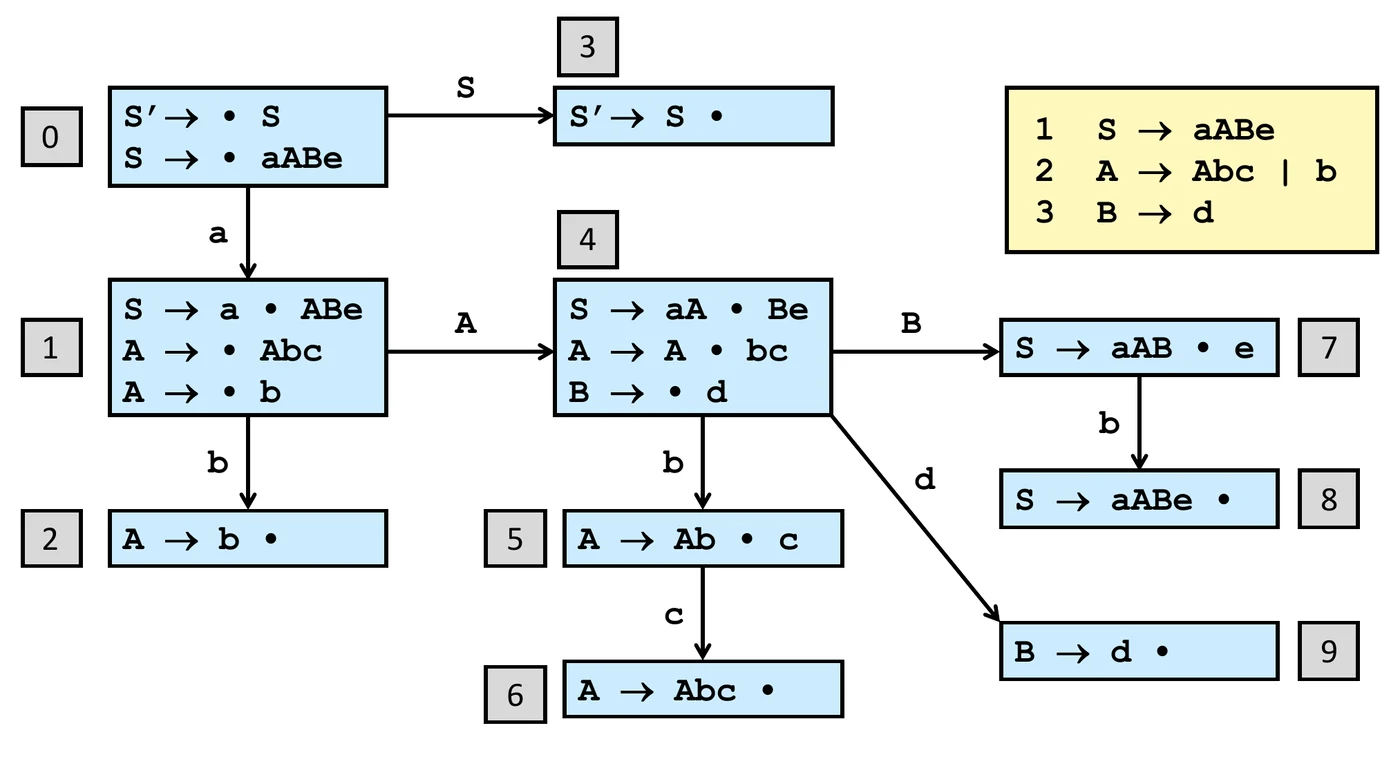
這樣建立起來的 DFA 叫做 characteristic finite-state machine (CFSM),我們可以幫每個 state 命名
S (Shift):讀入下一個 token,並移動到指定 stateR (Reduce):根據指定 production,將已辨識的 symbols 歸約成 nonterminal,接下來就透過 stack 重新找 gotoA (Accept):parsing 成功,輸入符合 grammar
這樣我們就能建立出完整的 Parse table
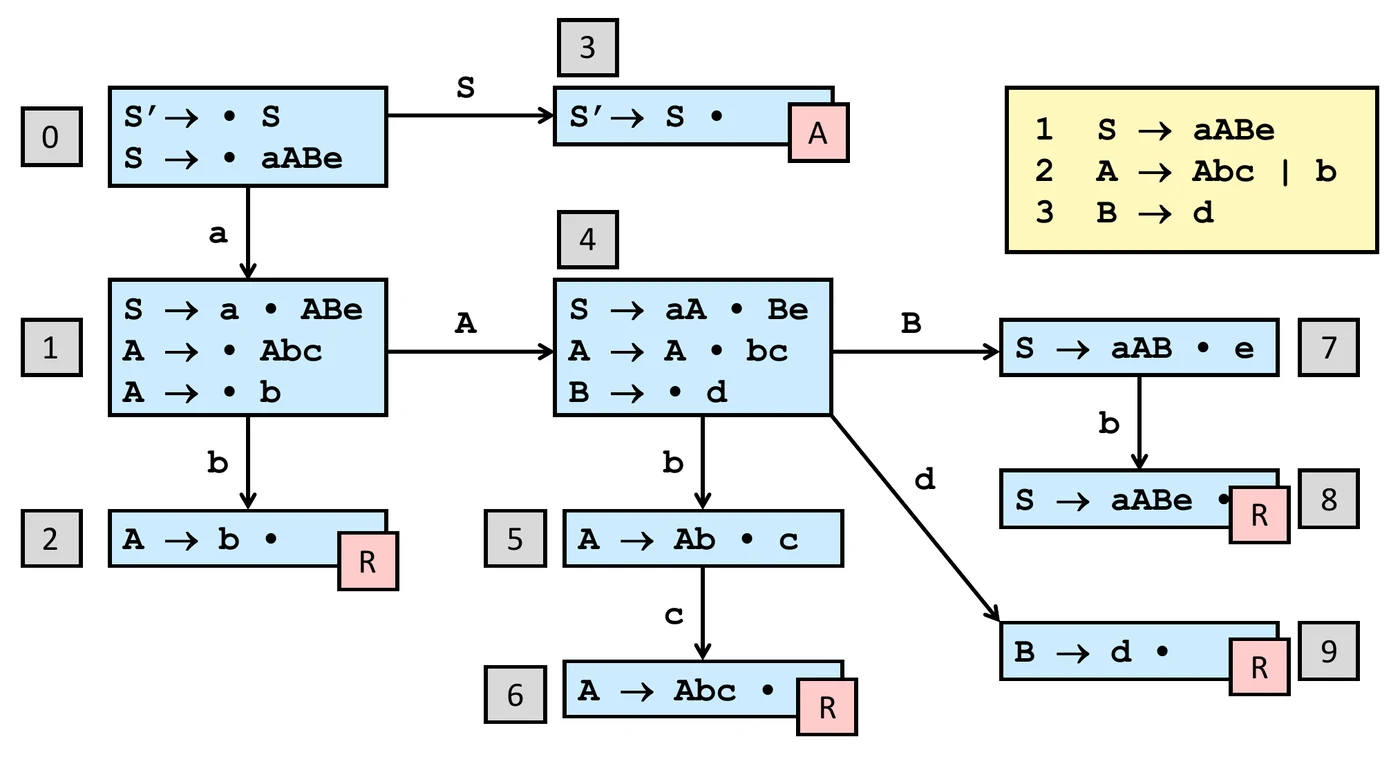
init GoTo repeat number R / A
C = {Closure({S' → •S})}
["C = {Closure({S' → •S})}","GoTo(I0, S)、GoTo(I0, a)","Repeat until no new item set","Number the states","Mark reduce (R) and accept (A) states"]
Problem of LR(0)#
有時候我們會遇到 Shift-Reduce Conflict,假設
I={A→a∙B→a∙b}
這個情況可以 reduce 也可以 shift,所以我們需要做一些 lookahead,來看下一步應該做啥,還有一種 Reduce-Reduce Conflict 也是一樣的問題,我們統稱 inadequate state
lookahead 也不一定可以解決所有問題,要用更強大的 parsing technique,比如說
A+B∙+C
我們做 shift 的話會變 right associative,而 reduce 會變 left associative,我們需要做更多判斷,而且有 λ-production 的話就一定會有 conflict
現代的 programming language 通常會有 λ-production 也會有 Operator precedence
SLR(1)#
LR(0) 只要看到 Dot 在最右邊,就準備 reduce,SLR(1) 則會額外檢查下一個 token 是否屬於 FOLLOW Set,才決定能不能 reduce,假設
I={E→T∙T→T∙∗id}
我們加入這個條件
Reduce A→αonly if a∈FOLLOW(A)
a 是 lookahead 的 symbol
不過 SLR(1) 能解決部分 Reduce-Reduce Conflict,只是 FOLLOW Set 不夠精確,可能還是有 conflict
stmtvarexpr→id∣var := expr→id→var
假設 stmt 後面接 ;,讀入 id 後得到:
I={stmt→id∙var→id∙}
FOLLOW(stmt)={;},FOLLOW(var)={:=,;}
當 Lookahead 為 ; 時,兩條 Production 都可以 Reduce,造成 Reduce-Reduce Conflict,但實際上,這個 State 中的 var→id∙ 來自 stmt→∙var := expr,因此後面只可能接 :=,不可能接 ;
問題在於 FOLLOW Set 考慮的是整個 Grammar,而不是目前 State 的 Context,因此 LR(1) 會為每個 Item 記錄更精確的 Lookahead,避免這種不必要的 Conflict
LR(1) Parser#
相較於 SLR(1) 使用整個 Grammar 的 FOLLOW Set,LR(1) 為每個 Item 記錄自己的 Lookahead,因此可以更精確地決定何時 Reduce。
LR(1) Item#
LR(1) Item 比 LR(0) Item 多了一個 Lookahead,定義如下:
I=[A→α∙β, {a}]
其中 a 是 Lookahead,表示當這條 Production 完成時,預期後面可以接的 Terminal,它只影響 Reduce,不影響 Shift。
如果多個 Item 只有 Lookahead 不同,可以合併表示:
[A→α∙, {a1,a2,…,an}]
Closure and GoTo#
若 Item 的 Dot 後面是 Non-terminal B:
[A→α∙Bβ, {a}]
對每個 Production B→γ,在 Closure(I) 裡面加入:
[B→∙γ, {b}],b∈FIRST(βa)
重複直到沒有新的 Item 可以加入。
GoTo:與 LR(0) 相同,將 Dot 移過指定 Symbol X,再做 Closure:
GoTo(I,X)=Closure({[A→αX∙β,{a}]∣[A→α∙Xβ,{a}]∈I})
LR(1) Parsing Table#
- 先利用 Closure 和 GoTo 建立所有 LR(1) States
- 根據每個 State 的 Items 填入 ACTION / GOTO Table
- Shift:若 [A→α∙aβ,{b}]∈Ii,且 a 是 Terminal,GoTo(Ii,a)=Ij,則 ACTION[i,a]=sj
- Reduce:若 [A→α∙,{a}]∈Ii,則 ACTION[i,a]=rA→α
- Accept:若 [S′→S∙,{$}]∈Ii,則 ACTION[i,$]=accept
- GOTO:若 GoTo(Ii,A)=Ij,且 A 是 Non-terminal,則 GOTO[i,A]=j
沿用前面的 Grammar,假設 stmt 後面接 ;,初始 State 包含:
I0=⎩⎨⎧[stmt→∙id,[stmt→∙var := expr,[var→∙id,{;}]{;}]{:=}]⎭⎬⎫
第三個 Item 由 Closure 產生,其 Lookahead 來自:
FIRST(:= expr ;)={:=}
經過 GoTo(I0,id),得到:
I1={[stmt→id∙, {;}][var→id∙, {:=}]}
因此只有看到 ; 才 Reduce stmt→id,看到 := 則 Reduce var→id
LALR(1)#
LALR(1) 是去優化 LR(1) 的 state machine,也就是去壓縮 LR(1) construct 出的 DFA
State 1:
PE→(E∙), {+,∗}→E∙+T, {),+})P→(E)∙, {+,∗}
State 2:
PE→(E∙), {),+,∗}→E∙+T, {),+})P→(E)∙, {),+,∗}
After Merging
PE→(E∙), {),+,∗}→E∙+T, {),+})P→(E)∙, {),+,∗}
Disadvantage#
但其實 LALR 不一定會優化到我們的 parsing 過程,假設我們有這個情境
SAB→aAd∣bAe∣aBe∣bBd→c→c
在 LR(1) 中,讀取 ac 與 bc 後,分別會得到:
State 1:
I1={A→c∙, {d}B→c∙, {e}}
State 2:
I2={A→c∙, {e}B→c∙, {d}}
兩個 State 都沒有 Conflict,因為不同 Production 的 Lookahead 不重疊,但由於它們有相同的 LR(0) Core,LALR(1) 會將它們合併:
After Merging
I={A→c∙, {d,e}B→c∙, {d,e}}
此時無論下一個 Token 是 d 還是 e,兩條 Production 都可以 Reduce,重新產生 Reduce-Reduce Conflict。
Summary of Parsing Method#
LR(1) 需要記錄的東西最多,所以他需要 memory size 也最大
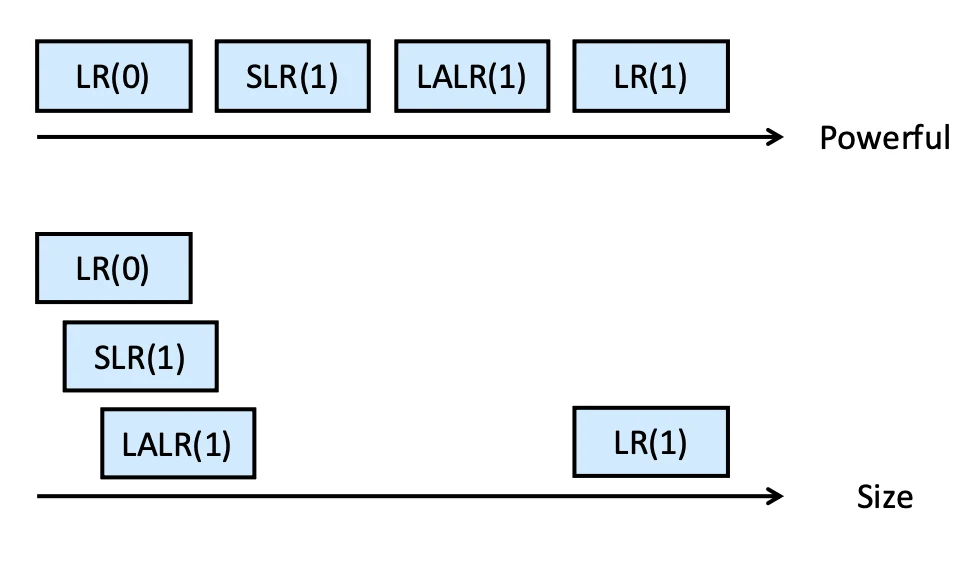 Power and Size
LL(1) Parsing 設計有很大的彈性,設計的好,可以跟 LR(1) 一樣 powerful,但糟的時候可以糟到跟 LR(0) 一樣
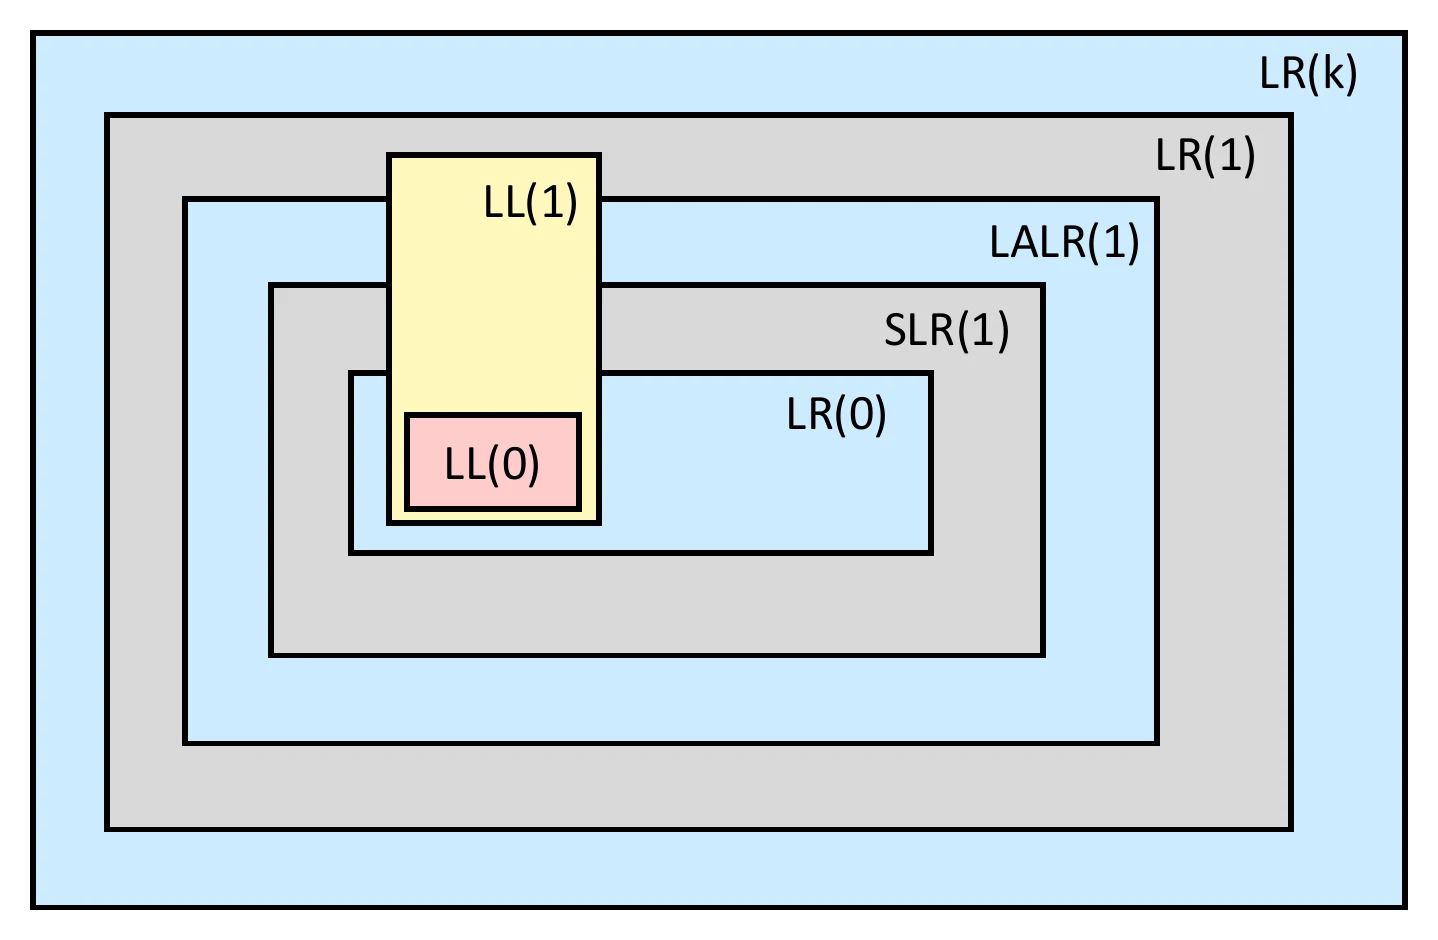 Different Parsing Method
Error Recovery in LR Parsing#
LR Parser 透過 ACTION Table 偵測 Syntax Error,當 ACTION[i,a] 沒有定義時,就代表發生錯誤
- LR(1):Lookahead 足夠精確,因此遇到不合法的 Token 時,可以立即偵測錯誤,不會在報錯前對該 Token 額外執行 Reduce
- SLR(1) / LALR(1):可能因為 Lookahead 不夠精確,先執行數次 Reduce 才發現錯誤,但不會 Shift 造成錯誤的 Token
Panic Mode Recovery#
當 Parser 發現 Syntax Error 時,可以透過以下步驟恢復 Parsing:
- Pop Stack:從 Stack 往下尋找某個 State s,使得 GOTO[s,A] 有定義,其中 A 是 Non-terminal
- Discard Tokens:丟棄輸入直到遇到可以接在 A 後面的 Synchronization Token (Sync Token),例如 ;、),通常可以從 FOLLOW(A) 中選擇
- Resume Parsing:將 A 視為已辨識,Push GOTO[s,A] 對應的 State,繼續 Parsing
Panic Mode 的目的不是修正原本的錯誤,而是跳過錯誤區域,讓 Parser 能繼續分析後面的程式