Scanning#
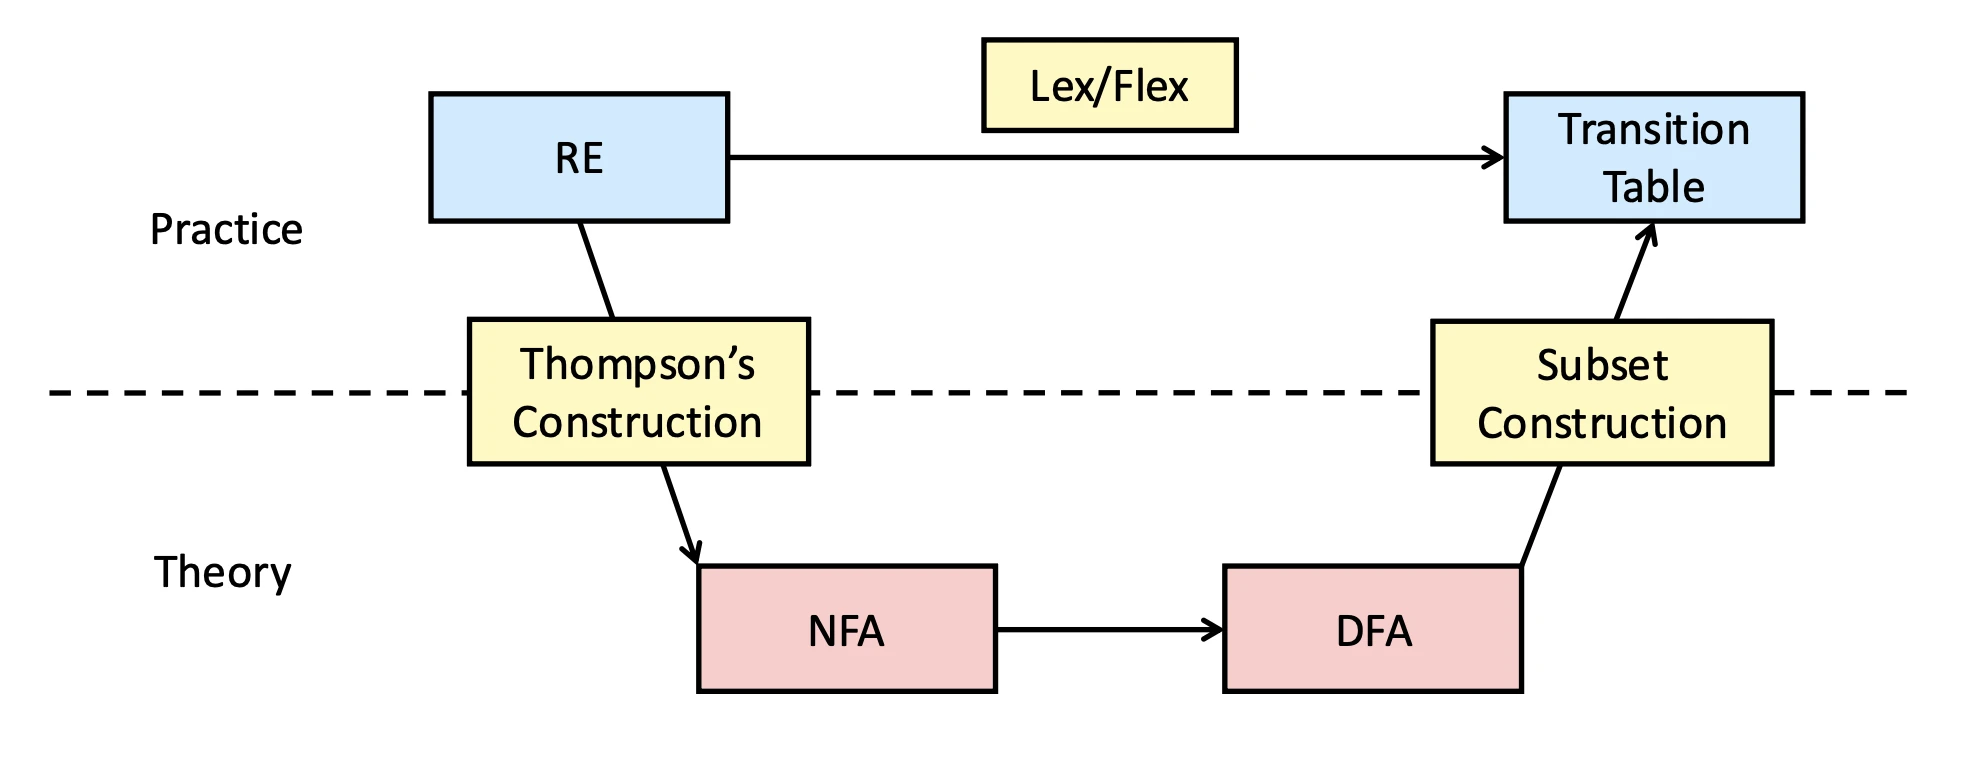
現代 Scanner 都是用 Regular expressions 來定義出 token,我們會用 Lex/Flex 等工具來把 RE 轉換成能用的 C language
現代 Scanner 的運作流程大概是
- 將整個 program load 到 memory 裡面
- 用一個 pointer 指向讀到的 memory 位置,用這個 pointer 代表目前讀到哪個 character
- 讀取抓 token
運作流程如下圖
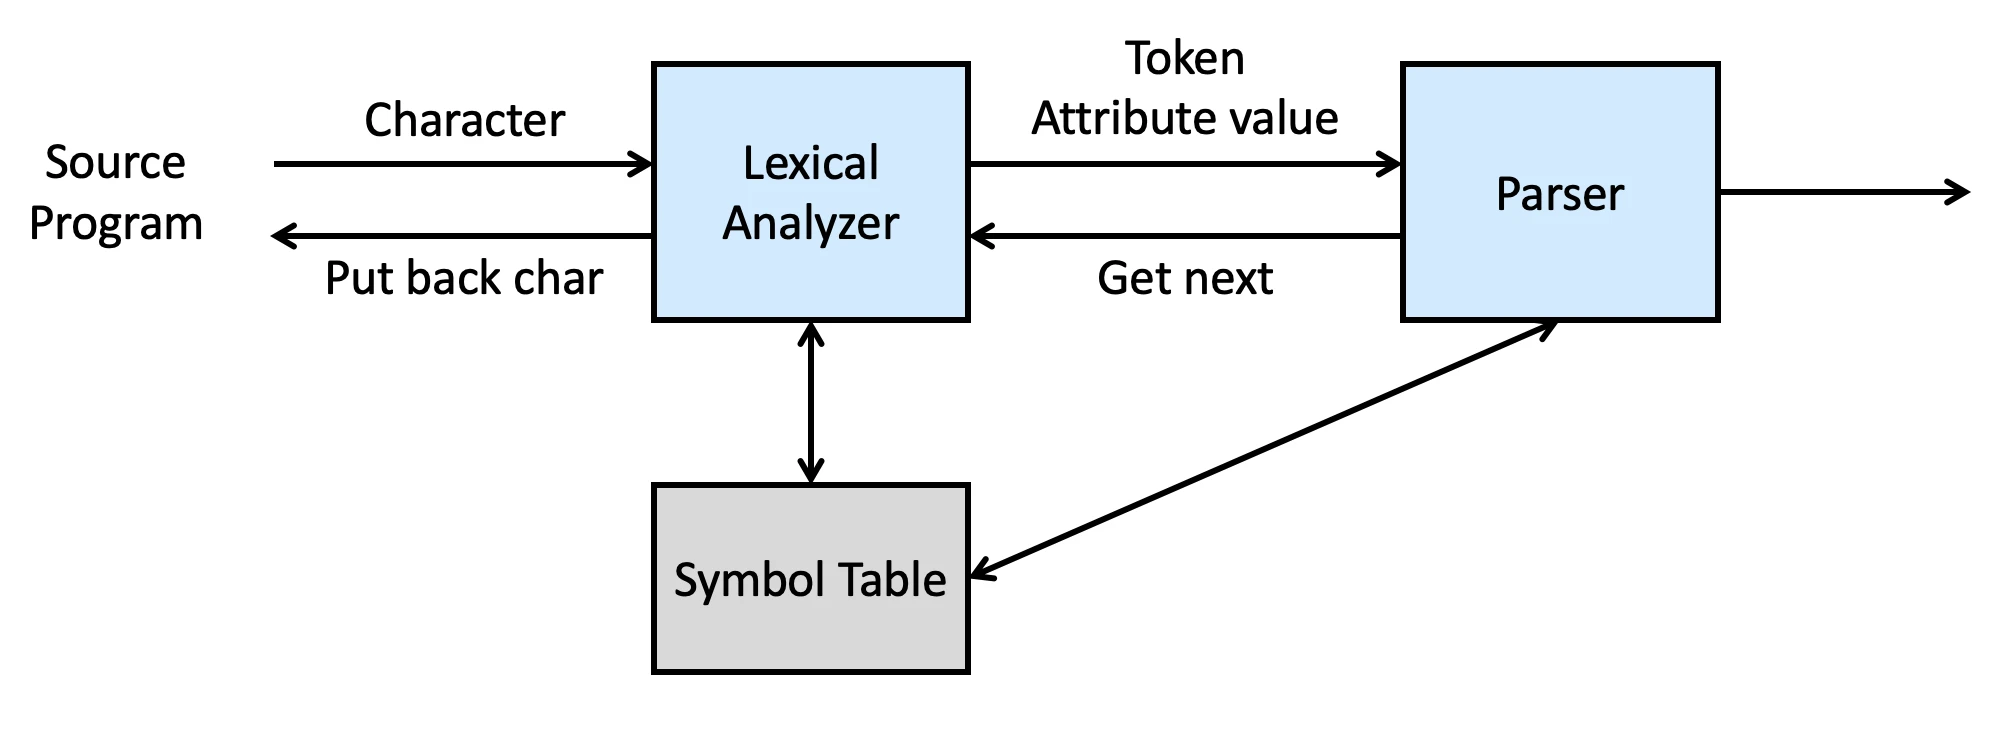
Scanner 有時候需要 lookahead 來做 tokenize 的確認,那個 put back char 的意思就是要把 lookahead 的那個 char 放回去,本質上就是挪動 pointer 到正確的位置
現代的 Scanner 是由 Parser 去驅動的,當 parser 需要 token 的時候,我們就需要 scanner 去讀取 character,Scanner 的功能如下:
- 把字元組成 tokens
- 把 comments, space 踢除
- 找到 error message 在 source program 的對應點
- Preprocessing(e.g. macro expansion
我們希望 scanner 要 portable, simple, efficient,不希望太常改動
Regular expression#
Regular expression 是一種可以形式化描述語言的方法,是一種字串的集合,我們稱這個集合叫做 regular set,會有以下幾個東西
- Vocabulary/Alphabet:一個 finite set
- String:由 的 catenation 組成的序列
- 有三種 operation concatenation, alternation (
|) and closure (*),這三種是 regular expression 真正有定義的操作 - 是 empty set
- 是 empty string
我們可以給某些 token 一個 Regular Definition,例如
letter = A|B|C … |a|b|c … |z
digit = 0|1|2| … |9
id = {letter}({letter}|digit)*
digits = {digit}{digit}*Regular expression 不允許 recursion 的定義,這也是他跟 CFG 最不一樣的地方
Common notation in RE#
| Alternation#
表示「或」,比如說 a|b 代表 a 或 b
* Kleene Star#
表示前面的 expression 可以出現 零次或多次,比如說 a* 可以匹配 "", a, aa, aaa…
? Optional#
表示前面的 expression 可以出現 零次或一次,比如說 a? 可以匹配 "" 或 a,也可以寫成 (a|λ)。
+ One or More#
表示前面的 expression 可以出現 一次或多次。
比如說 a+ 可以匹配 a、aa、aaa 等,但不能匹配 empty string ""。
[] Character Class#
表示匹配括號內的任意一個字元。
比如說 [abc] 代表 a、b、c 其中一個;[0-9] 代表任意一個數字。
^ Negation / Beginning Anchor#
放在 [] 開頭時表示 排除,比如說 [^abc] 代表任何不是 a、b、c 的字元。
在某些 Regex 語法中,放在 expression 最前面表示字串的開頭,比如說 ^abc 表示字串必須以 abc 開頭。
- Range#
在 [] 中表示一段字元範圍。
比如說 [a-z] 代表所有小寫英文字母,[0-9] 代表所有數字字元。
\ Escape Character#
用來取消特殊符號原本在 Regex 中的意義。
比如說
.原本代表任意字元,而\.則代表真正的.字元\n表示換行\d就是[0-9]\t是 tab 的意思
{} Repetition#
用來指定前面的 expression 重複幾次。
比如說 a{3} 代表 aaa,而 a{2,4} 代表 a 出現 2 到 4 次。
() Grouping#
將多個 expression 組成一個整體。
比如說 (ab)* 表示整個 ab 可以重複零次或多次,因此可以匹配 ""、ab、abab 等。
. Wildcard#
表示任意一個不包含換行字元,比如說 a.b 可以匹配 acb、a1b、a_b 等。
Operator Precedence#
通常遵守
或更詳細點說遵守下面這個順序
():Grouping*,?,{}:Repetition- Concatenation
|:Alternation
Non-regular Set#
有些東西沒辦法被 RE 表示,比如說 symmetric of parenthesis,這種東西需要 CFG 的 recursion structure 表示才有辦法定義出來,沒辦法用 Regular expression
Finite Automata#
要把 regular expression 轉換成 scanner code,我們需要先轉成一個 Finite Automata,我們先把 RE 轉換成 Nondeterministic Finite Automata (NFA),這種自動機會有以下幾個東西
- A set of states
- A set of input symbols
- A transition function 也就是所有 state 對應 symbols 的 map
- A start state
- A set of accept states
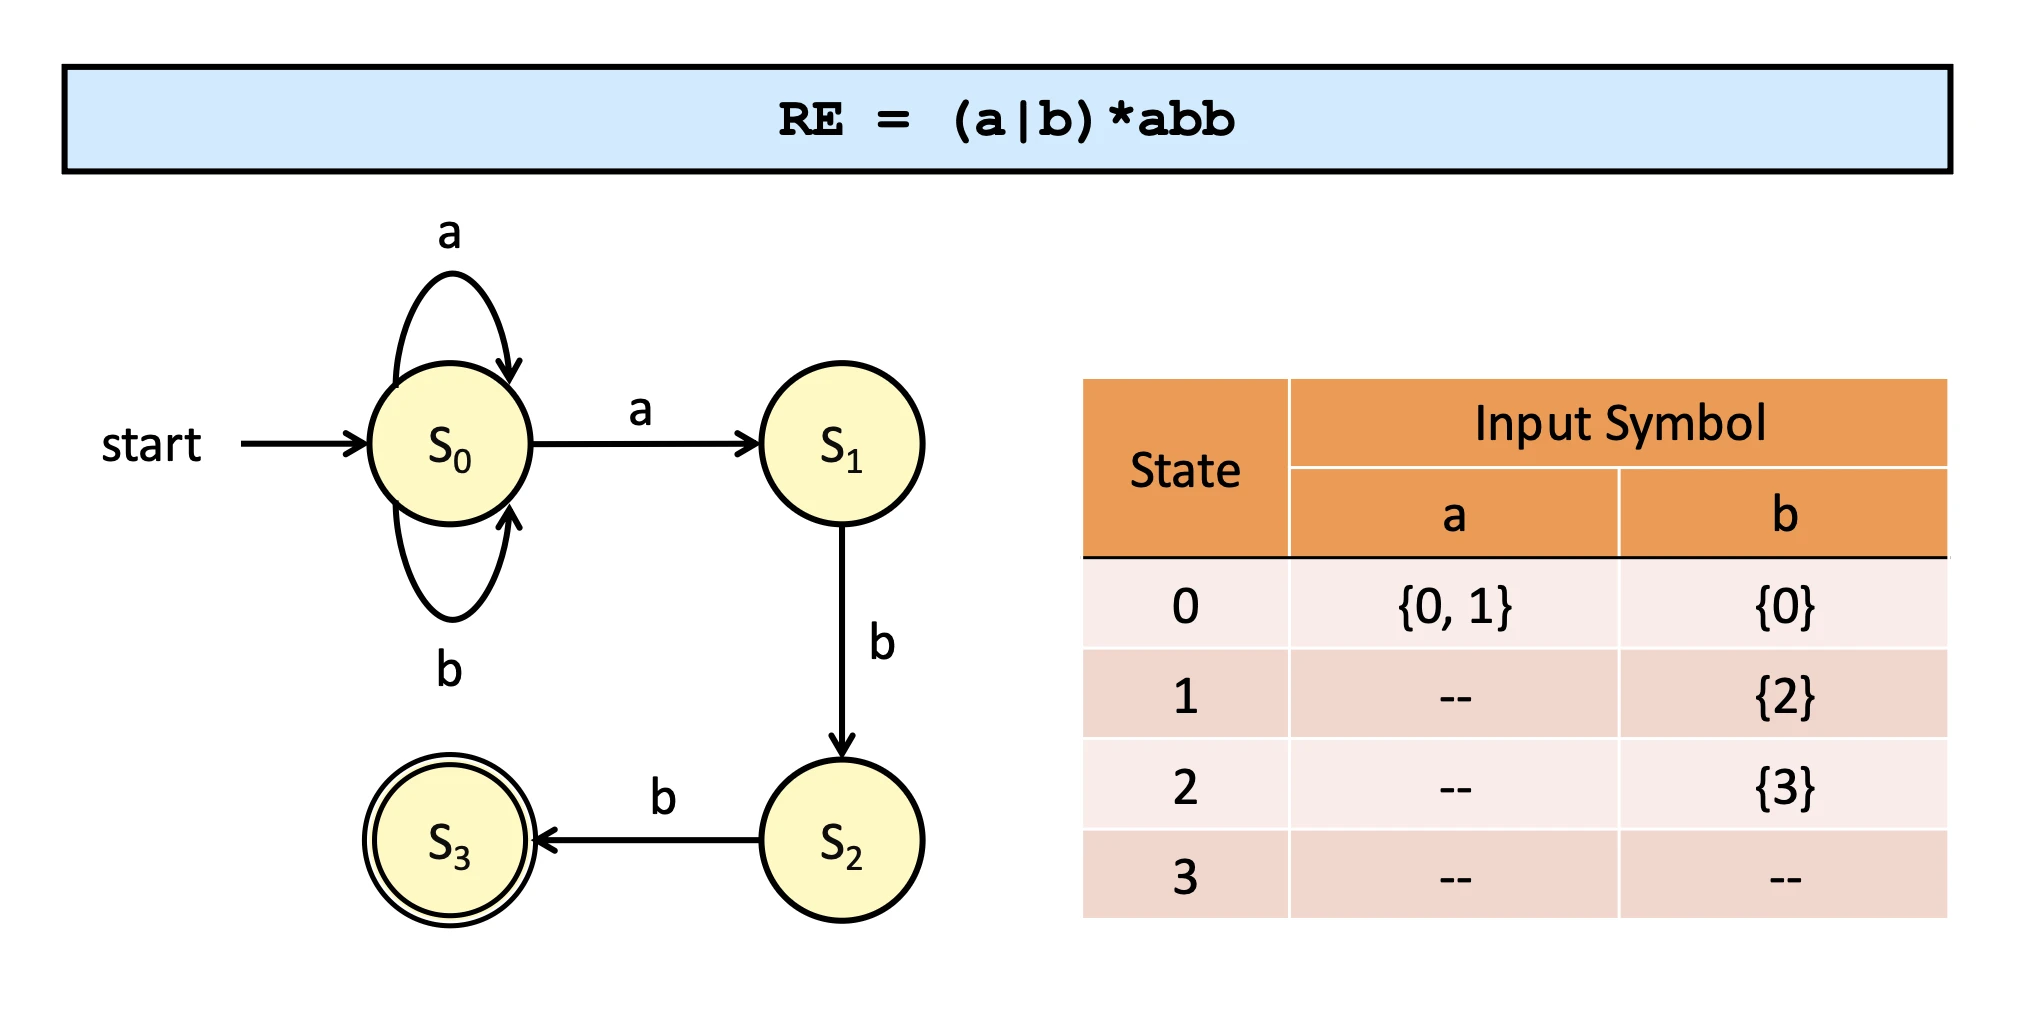
有另外一種 Automata 叫做 Deterministic Finite Automata (DFA),以下是幾個 DFA, NFA 的不同之處:
Nondeterministic Finite Automata (NFA)
- 可以有 transition
- 可以有同一個 input 多的 transit state 的情況
- 只要有任意一條 transition 可以完整把 string 吃完,就表示 NFA accept this string
Deterministic Finite Automata (DFA)
- 不可以有 transition
- 每個 state 加上一個 input 的 transition 一定是 unique 的
Scanning a token#
State ← StartState
while true do
    NextState ← T[State, CurrentChar]
    if NextState = error
        then break
    State ← NextState
    CurrentChar ← READ()
if State ∈ AcceptingStates
    then /* Return or process the valid token */
else /* Signal a lexical error */簡單來講我們要先把一個 token scan 進來我們需要
- Regular expression 轉換成 NFA
- 把 NFA 轉換成 DFA
第二步需要執行的原因是因為,做 NFA 的 simulation 是一件很沒有效率的事情,因為路線有太多種了,我們需要維護這個資料結構的話需要很大量的資源
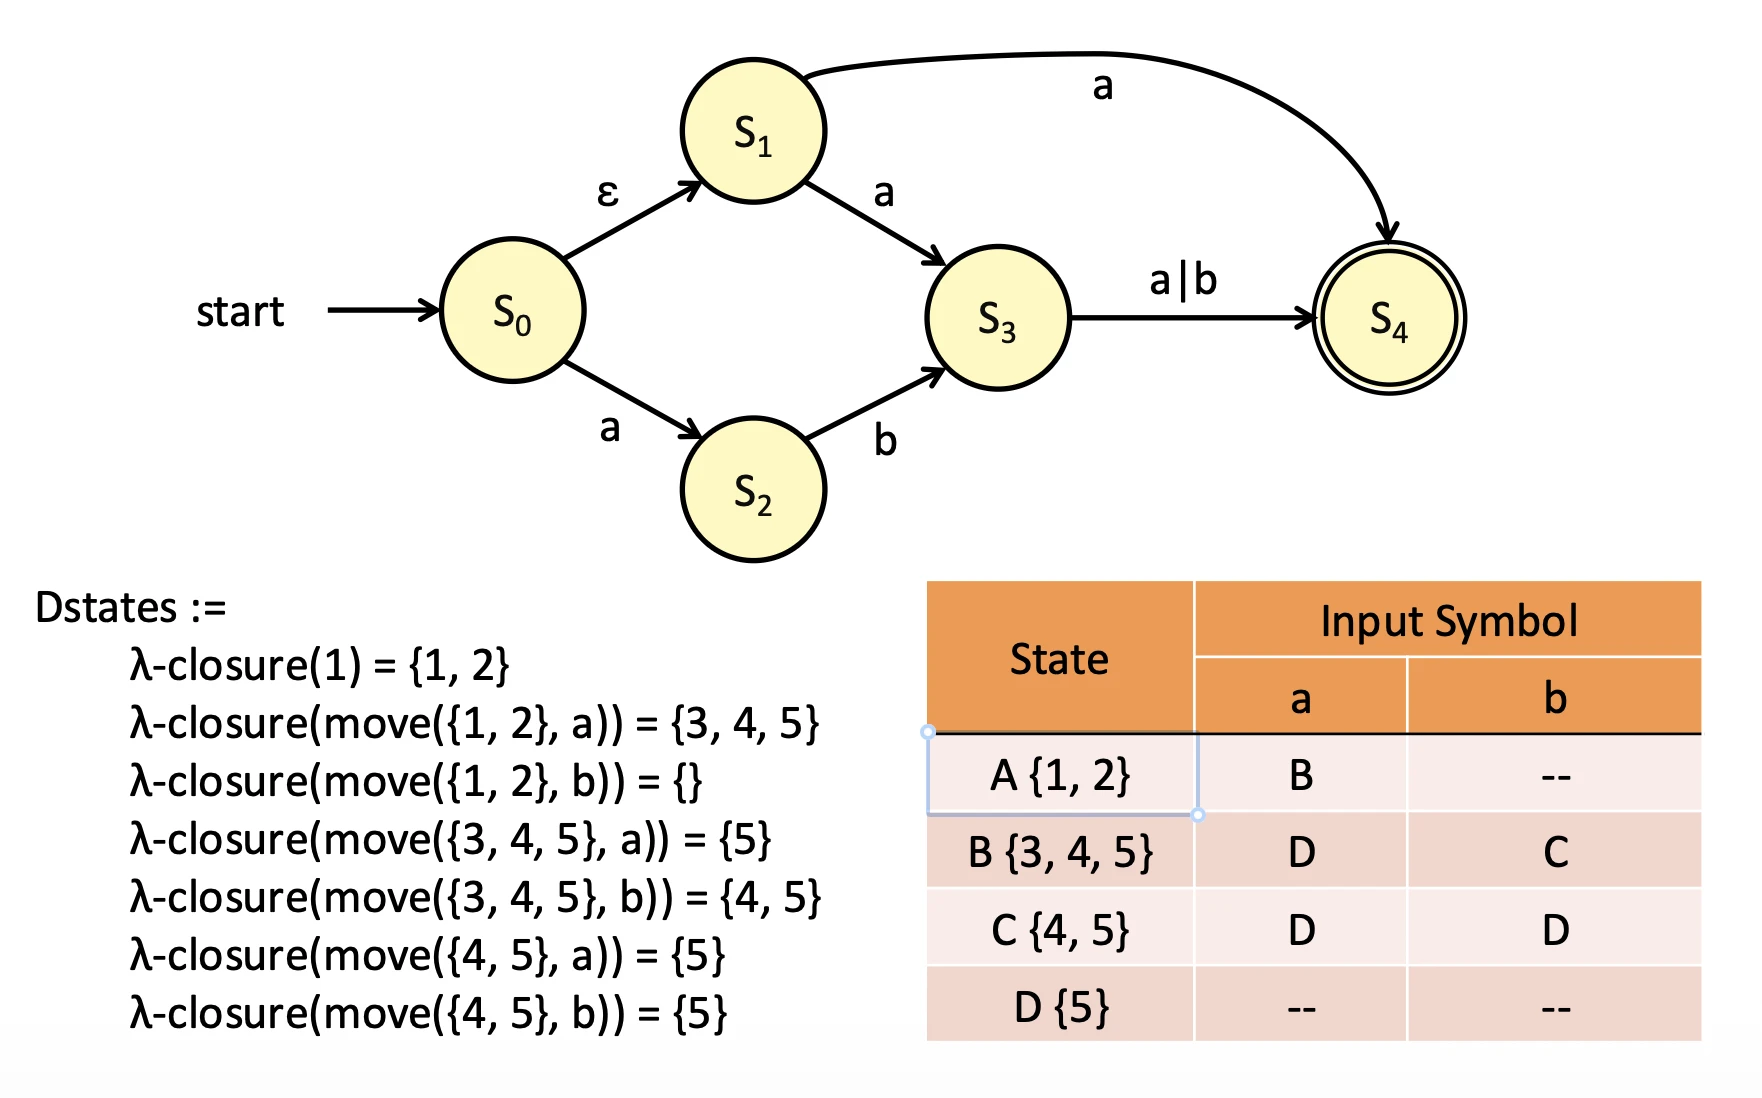
而該如何進行 DFA conversion 有一個專門的 Conversion algorithm,叫做 subset construction,直接用一個 example 講解
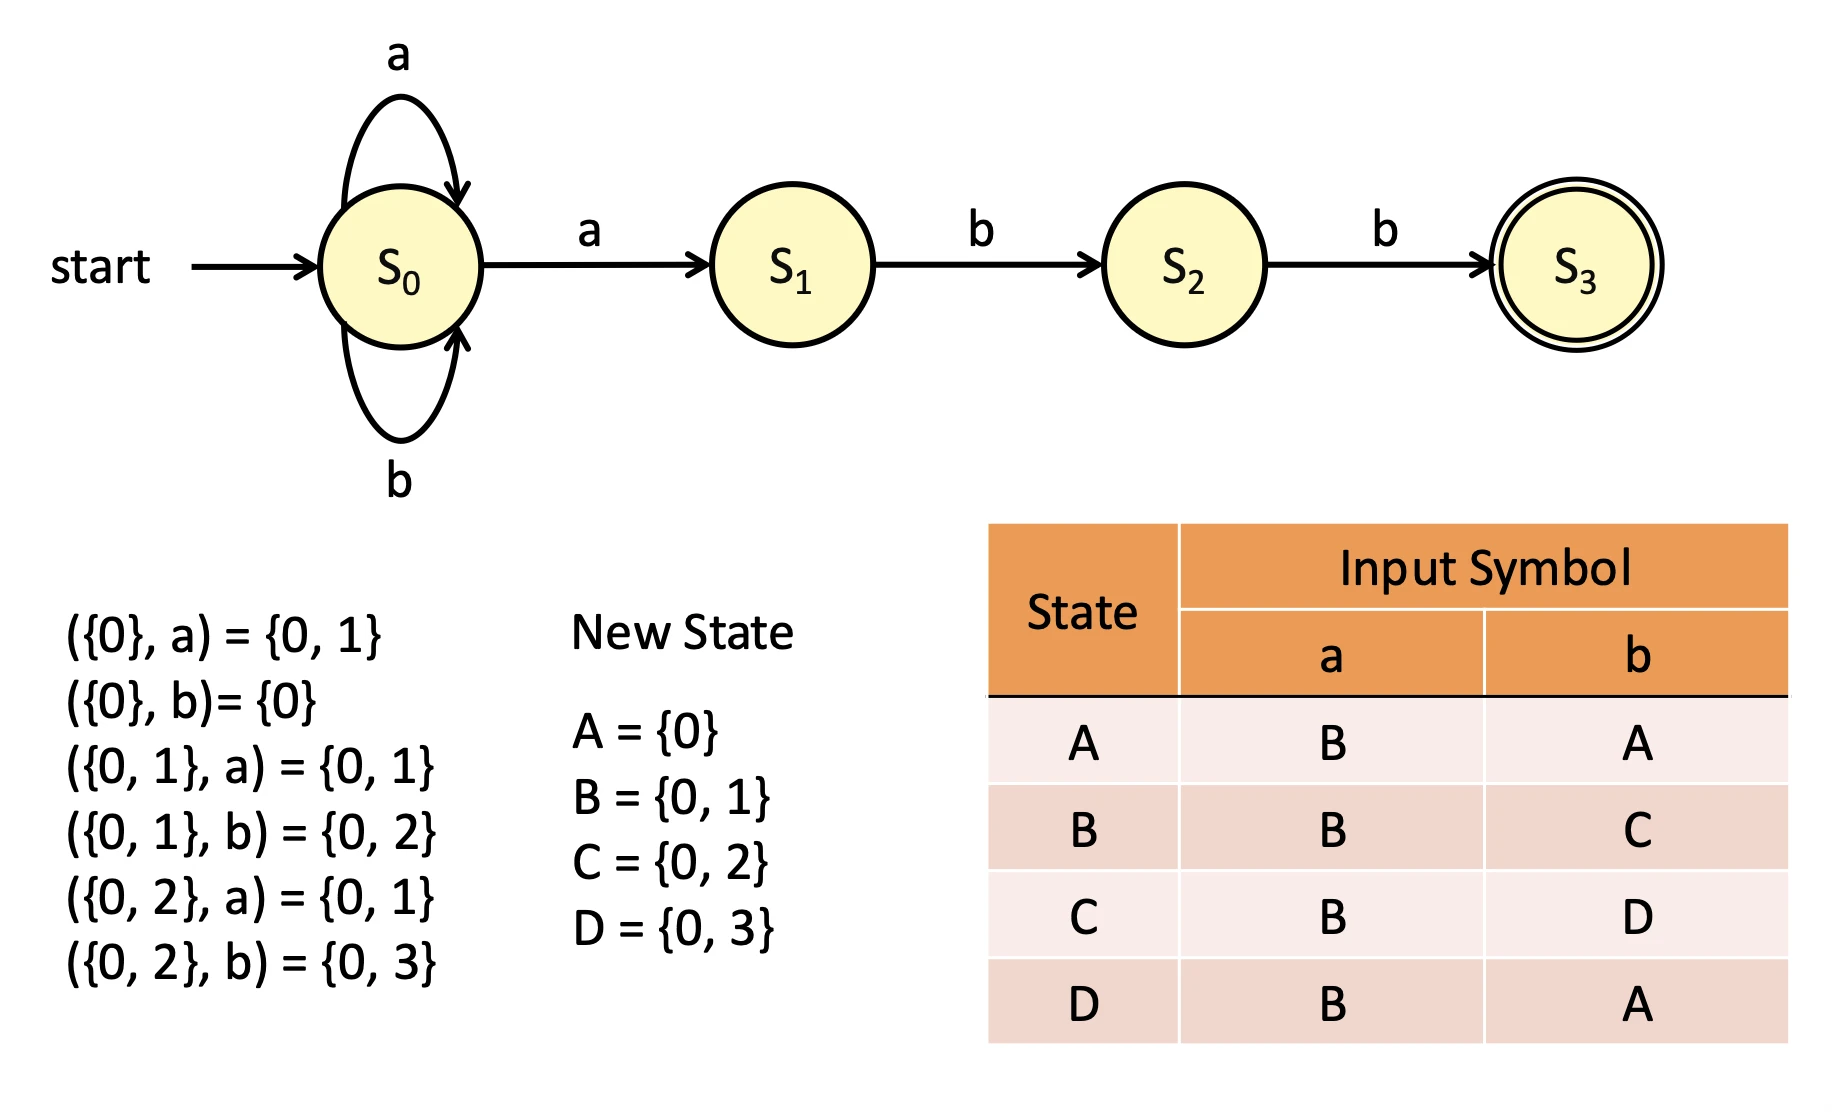
而當出現 -transition 的時候,我們需要引入一個新觀念
是一個 state, 就是所有在這個 state 可以經過 -transition 加上他本人的所有 state 的一個 set
Dstates := λ-closure(s0)

while there is an unmarked state T in Dstates do
begin
    mark T
    for each input symbol a do
    begin
        U := λ-closure(move(T, a))
        if U is not in Dstates then
            add U as an unmarked state to Dstates
        Dtran[T, a] := U
    end
end流程大約是
- 先計算 start state 的 -closure,並把這個 state set 當作 DFA 的 start state
- 對目前這個 state set 中的所有 NFA states,考慮每一個 input symbol
- 計算這些 states 經由 可以到達的所有 states,也就是
- 再對 計算一次 -closure,得到新的 state set
- 如果 還沒有出現在 DFA 中,就把它加入 Dstates,視為一個新的 DFA state
- 建立 transition
- 對所有尚未處理過的 DFA states 重複以上步驟,直到沒有新的 state 出現為止
Map RE to NFA#
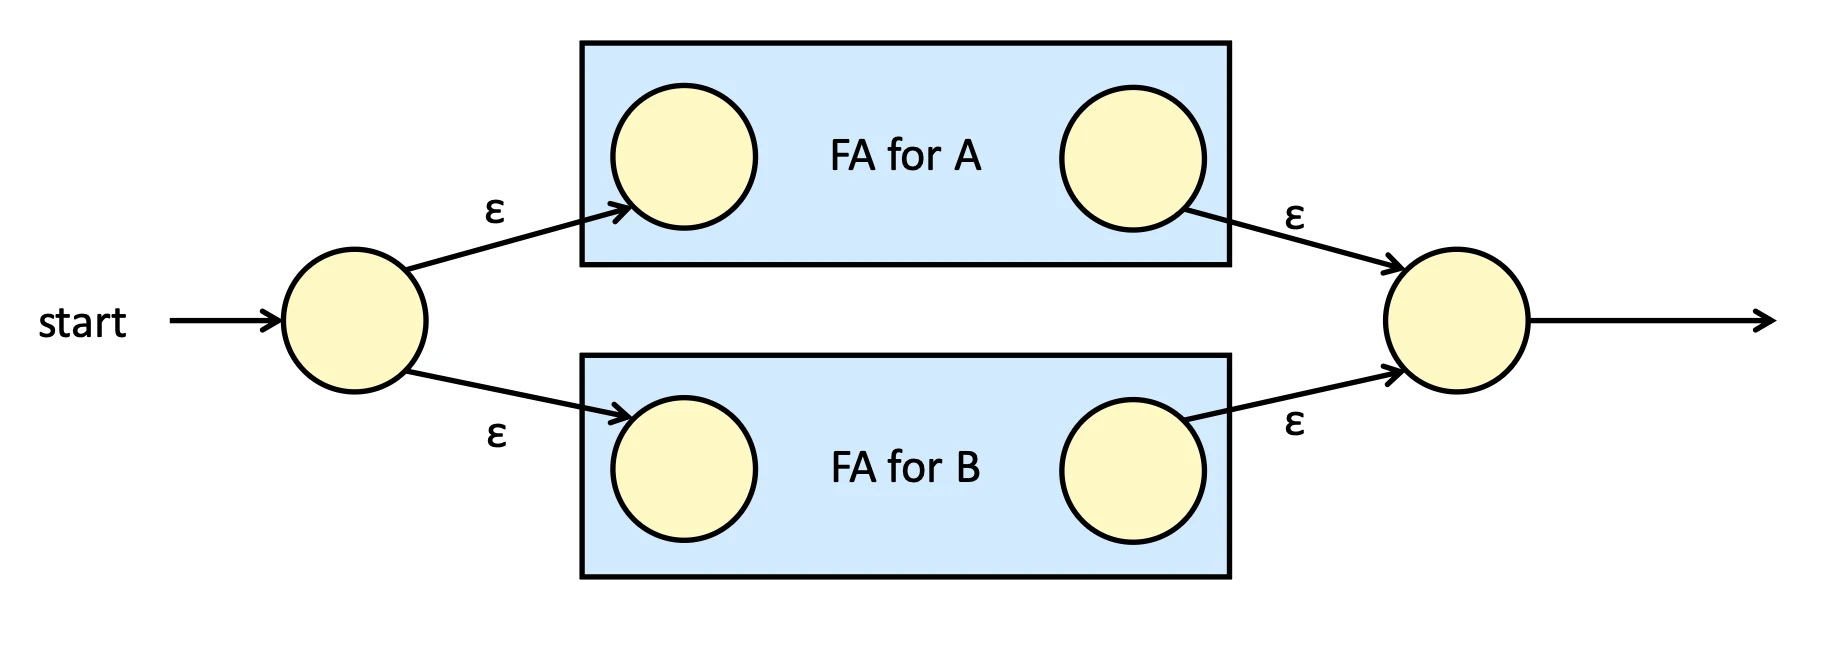
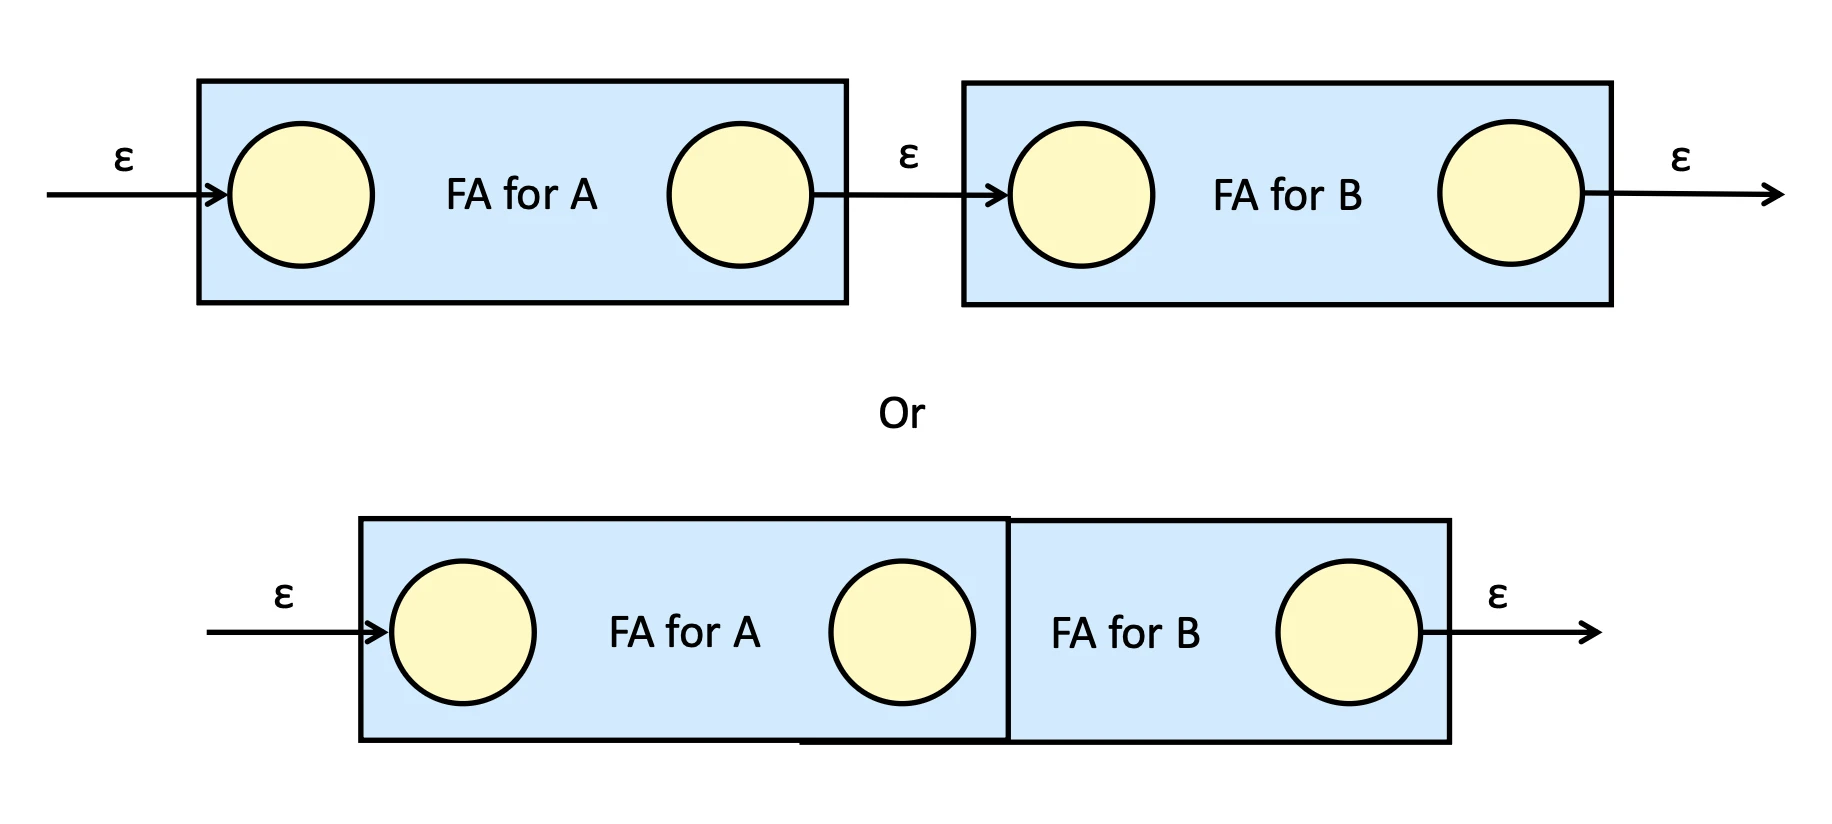
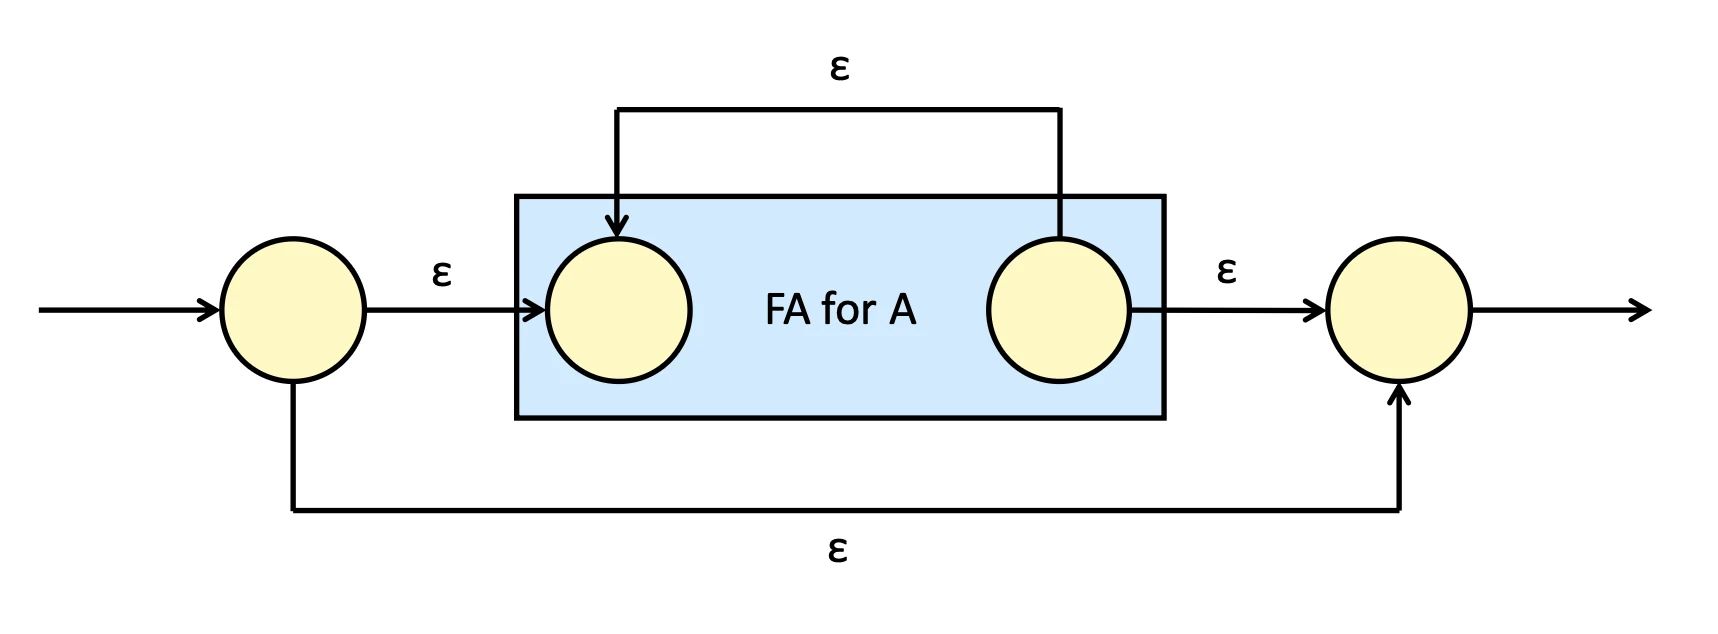
有一套方法可以把 Regular expression Map 到 NFA 上,叫做 Thompson’s construction,以下是幾個簡單規則
A|Balternation
ABconcatenation
A*kleene star
Optimizing Finite Automata#
這樣做出來的 NFA 轉換成 DFA 後不一定會是最簡的版本,因此我們要進行一段 optimization,簡單來講我們做的事情是:「先全部盡量合併,再利用 transition 的不同逐步拆開,直到不能再拆」
- 先把所有 states 分成兩組:
- Final states
- Non-final states
- 從任意一個 merged state 開始檢查。
- 選一個 input symbol ,看每個 state 讀到 之後會走到哪裡:
- 檢查所有 是否都落在同一個 merged state 中。
- 如果是:代表這些 states 在 input 下的行為一致,不用拆。
- 如果不是:代表它們的行為不同,需要把 拆開。
- 拆分時,把「讀 後會到同一個 merged state」的 states 分在同一組。
- 對所有 merged states、所有 input symbols 重複上述檢查。
- 一直重複,直到再也沒有任何 state group 可以被拆分。
- 最後每一組中的 states 都是 equivalent states,可以合併成一個 state,得到最小化的 DFA。
Size of transition table#
DFA 的 Transition Table 通常會用 2D Array 儲存,雖然 access 很快,但 Table Size 可能很大(10KB ~ 100KB),因此我們希望透過 Table Compaction 來減少空間。
有兩種常見的壓縮方式:
-
Eliminating Redundant Rows and Columns
- Transition Table 通常會有很多 identical columns 和一些 identical rows,我們可以把重複的部分合併,只儲存一份。
- 透過
rmap和cmap記錄原本的 state 和 character 對應到哪個 row / column。 - 原本的
T[s, c]就改成T[rmap[s], cmap[c]],可以節省大量空間。
-
Pair-Compressed Transition Table (Sparse Table)
- 如果大部分 state 只有少數合法的 transition,就不需要儲存完整的 2D Array。
- 每個 state 只儲存有用的
(character, next state)pairs,並透過 pointer 找到對應的 transition list。 - 例如 State 1 只有
a → 4、c → 6,就只需要儲存這兩組 pairs。
這些方法可以減少 Memory Usage,但可能需要額外的 mapping 或 searching,因此會有一些 Time-Space Tradeoff。
Practical Consideration#
還有一些問題在實際的 implementation 需要被考慮到
Reserved Word#
比如說
(IF) THEN (THEN) THEN = ELSE (ELSE) ELSE = THEN;哪個是變數哪個是 keyword,只有被括號起來這些是 keyword
在 c language 裡面我們可以
typedef int a;
a (*b);那下面這行到底要被解讀成 function call 還是 pointer declare
這些例子都可以用 look ahead 去猜一下,但
begin
    begin;
    end;
    end;
    begin;
end這樣根本猜不出誰是保留字誰是變數,所以現代程式語言會把 keyword, reserve word 禁止命名成變數
Compiler Directives#
有些額外的資訊我們可以告訴 compiler,讓他進行優化,寫完 code 後加一些 pragma 就好了,比如說
#pragma simd;
#pragma openmp;或著有一些 source inclusion
#include在或著有一些 conditional compilation
#if
#endif 這些在現代的 compiler 裡面通常會交給一個額外的 preprocessor 去處理這個問題
Entry of ID into the Symbol Table#
{ int a;
    …
    { int a; }
}每個 variable 會在不同的 scope 裡面,scanner 沒辦法認出來,要交給 parser 進行分析後才知道,才能把它們放進 symbol table 裡面,所以現代 compiler 通常會把 symbol table 的 insertion 放在 parser 裡面做
Scanner Termination#
當 scanner 讀到 EOF 通常會停止,但因為現代的 compiler 是 parser 驅動的,現代 scanner 通常就會不管繼續讀給 parser,因為 parser 應該要做到 handle 這件事,不應該由 scanner 處理(有這個東西出來是因為多檔案 compilation)
Lexical Error and Recovery#
有些簡單的錯誤可以被 scanner 找出來而且要可以一次找到很多錯誤,所以 scanner 會做到幾件事
- Error detection
- Error reporting
- Error recovery
現代 compiler 不應該自己修復使用者的 code,而應該要保留,但 compiler 為了要一次回報錯誤多一點,會自己偷偷做一些 error recovery,讓 program 可以繼續跑下去,假設有一個錯誤宣告 va@r,而 @ 是不被接受的,那 scanner 可能有幾種解決方法
- 直接刪掉這個讀到的 char
- 把 scanner 這輪讀到的東西,第一個 char 刪掉,直到刪到對了為止
LEX#
LEX 是一個 lexical analyzer generator,我們可以只寫 RE 就可以生成 scanner
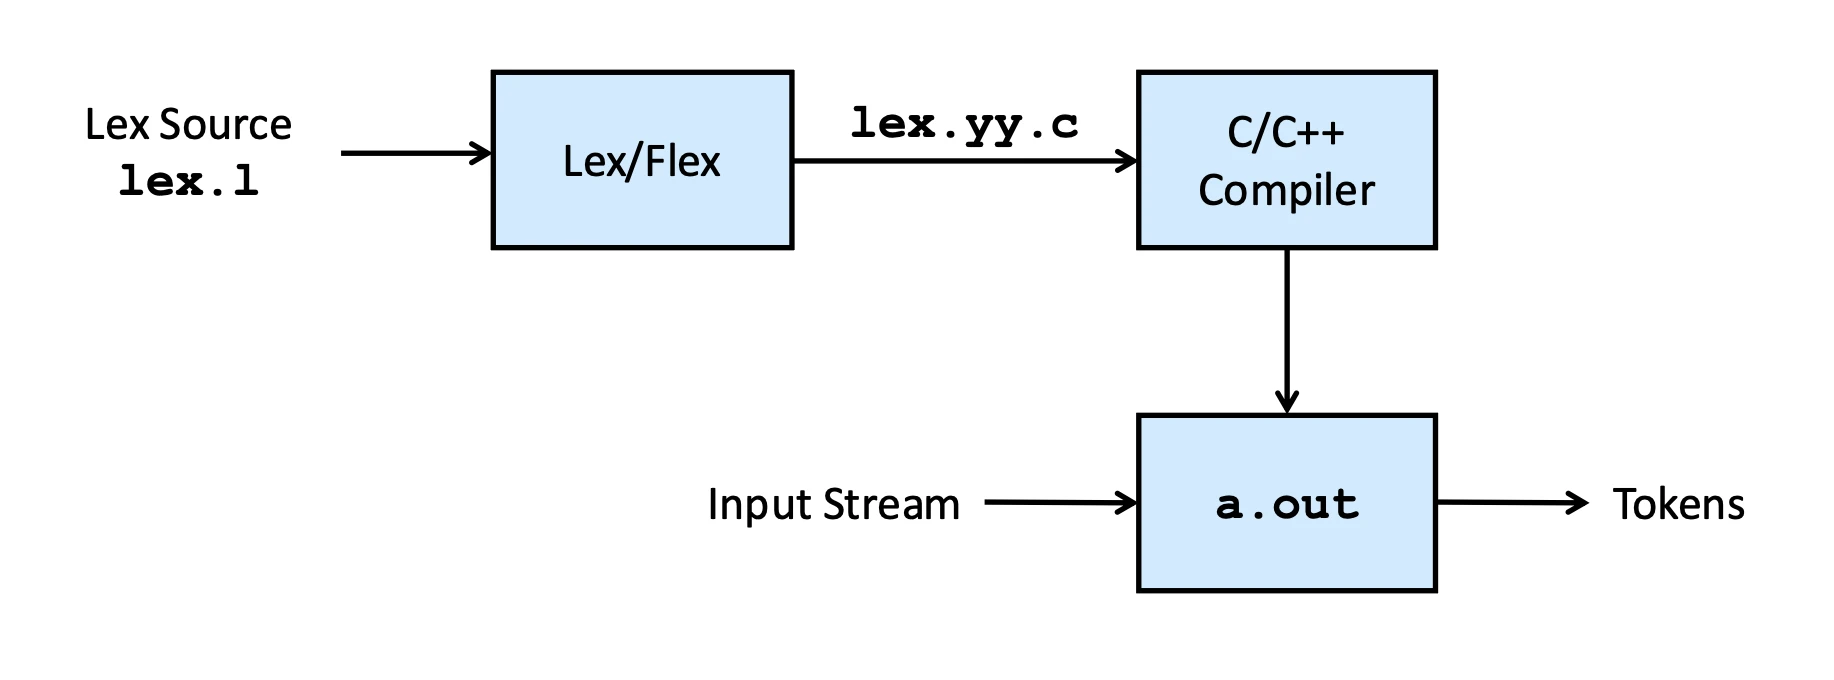
%{
#define THEN 5
#define ID   100
%}
WS      [ \t]+
letter  [A-Za-z]
digit   [0-9]
id      {letter}( {letter} | {digit})*
%%
{WS}    {}
{id}    {yylval = insert_id(); return(ID);}
%%
Insert_id() {…}基本上遵循
Definition section
%%
Rules section
%%
Subroutine section的結構
LEX 如果發現你同時有兩個 rule 都 match 某一個 string,那 LEX 會以前面那個為準,另外如果 LEX 會以最長的那條 rule 去做 match,比如說如果是 <= 他不會 scanner 成 < 跟 =
yytext:儲存目前辨識到的 token 文字內容yyleng:目前 token 文字的長度yylineno:目前讀取到的行號yylex():尋找下一個 token,並回傳代表該 token 的整數值yywrap():由使用者提供的函式- 如果已經沒有更多輸入需要處理,回傳
1 - 如果還有輸入要繼續處理,回傳
0
- 如果已經沒有更多輸入需要處理,回傳
yyin:指定 Lex/Flex 的輸入檔案yyout:指定 Lex/Flex 的輸出檔案
實際上我們只需要 transition table 就好了,圖示只是一種示意而已